
文 观察者网 孙珷
NVIDIA首席执行官黄仁勋在多重压力下辞职。这一突发事件迅速在国际金融市场激起波澜,外界普遍预期海外针对先进计算芯片的供应限制将进一步趋紧。
但这种担忧可能是过度的。来自路透社与多家海外技术社区的资讯显示,以智谱和DeepSeek为代表的中国顶尖人工智能企业,早已开启对本土计算芯片的深度工程适配,目前正在国产计算集群上推进5万亿至10万亿参数级别的下一代基座模型训练。外部技术封锁带来的供应链波动,正在以极快的速度演变为推动本土芯片与自研算法深度绑定的发展契机。
逆向权重分析揭示的硬件轨迹
长期以来,欧美科技界普遍存在一种惯性思维,认为离开了NVIDIA最新的高端硬件,任何团队都无法训练出具备全球顶尖水平的前沿模型。
然而,2026年11月由前OpenAI研究员Will DePue发布的一份详尽逆向取证报告,打破了这种技术垄断预期。Will DePue曾参与开发OpenAI的多款前沿多模态与推理系统,他通过数学推演与超大规模穷举测算,对全球各大实验室公开发布的模型权重进行了底层硬件指纹比对。
Will DePue通过测算发现,虽然部分中国初创团队在2026年上半年的特定测试版本中使用了海外高端硬件生成的初始权重,但在许多国产最新模型权重中,比如百度的ERNIE-5.5,美团的LongCat-2.0,DeepSeek-V4.1-Flash等,完全没有找到任何NVIDIA最新的Hopper架构H系列或者Blackwell架构B系列芯片的运算痕迹。
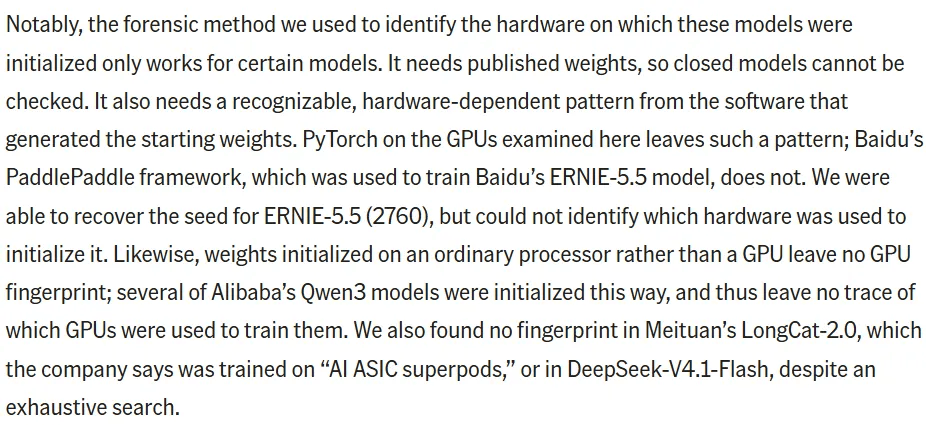
报告显示,百度的ERNIE-5.5,美团的LongCat-2.0,DeepSeek-V4.1-Flash等都不匹配英伟达芯片指纹
报告从反向技术验证的角度证实,中国最新一批参数规模达到千亿乃至万亿级别的旗舰模型,确实已经将关键训练环节迁移到了非NVIDIA的本土硬件平台之上。海外部分观察家原本试图通过模型权重寻找技术封锁产生漏洞的证据,最终呈现在全球技术同行面前的数据却显示出完全不同的事实,中国正在建立一套脱离海外供应链依赖的独立研发流程。
提前数年的异构算力工程积累
很多人以为硬件替代是近期才出现的紧急应对措施,事实并非如此。
比如,智谱早在2020年至2022年期间就已经启动了国产芯片的深度工程适配。在行业绝大多数开发者尚未充分认知大规模语言模型潜力的2020年,智谱技术团队就在位于成都的超级计算集群上,使用国产海光芯片完成了29亿参数模型的实际训练。2021年,他们又使用华为昇腾910A芯片成功训出包含130亿参数的专业代码大模型CodeGeeX。
六年时间里,智谱先后在海光系列、华为昇腾910A、昇腾910B等多种不同架构的国产芯片上完成实训任务。2025年,智谱基于昇腾910B完成了多模态图像生成模型GLM-Image的研发,从海量多模态数据预处理一直到超大规模并行预训练,全流程均在国产硬件上跑通,最终在文字渲染精度测评中达到全球开源领域顶尖水准。
根据智谱2026年中期财报披露的公开信息,该公司已经实现了10万张级别国产计算芯片的规模化稳定运行,其最新推出的旗舰模型GLM-5全面适配国产硬件体系。路透社与The Information在2026年的追踪报道中还透露,智谱甚至已与国内主流芯片设计企业展开联合研发,针对下一代GLM大模型的特定运算图结构定制专有计算硬件。
为了化解不同芯片之间底层指令不兼容、算子库必须反复重写的行业难题,智谱在2026年7月完成了对国内异构计算软件企业中科加禾的全资收购。这支由150名资深工程师组成的技术团队源自中国科学院计算技术研究所编译实验室,曾深度参与龙芯、神威、寒武纪、华为昇腾等多种国产芯片的高性能编译器研发工作。他们的核心业务是构建跨越不同芯片架构的统一中间层与算子优化工具,让同一个超大规模模型无需经历冗长的移植周期,即可在不同厂商的计算硬件上高效运转。
这一系列的工程化投入直接反映在企业的财务数据上。智谱的公开财报显示,得益于硬件调度效率的提升与算力自给程度的提高,其单位词元处理成本在短短半年内下降了80%,主营业务毛利率转正并攀升至24.6%,年度经常性收入从2.5亿美元大幅提升至16亿美元,并在2026年年底预计突破30亿美元。
不仅在国内市场,海外成熟商业机构也开始规模化采购部署中国自研模型。英国科技媒体The Register在2026年11月报道,英国金融科技企业Revolut为了支持其内部2000名工程师的日常软件开发,全面引入智谱GLM-5.1和GLM-5.3作为其核心辅助编码引擎,最终使其整体推理成本削减了90%,研发任务的交付周期指标改善了70%。海外知名企业在生产环境中对中国开源及商业模型的规模化采纳,证明了脱离特定海外硬件构建的软件生态同样具备国际竞争力。
国产芯片承载大模型训练的清晰演进
在算力供给面临更大不确定性的背景下,中国人工智能研发机构没有放慢向超大参数规模挺进的脚步。近期海内外科技圈持续流传着一项重磅动向,智谱与DeepSeek正在依托本土计算集群,全力推进5万亿至10万亿参数级别的下一代超级基座模型预训练。
回顾过去六年的发展轨迹,国产芯片承载大模型训练经历了清晰的三个演进阶段。
从2020年到2023年,行业处于探索技术可能性的起步阶段,国产硬件主要在百亿级别参数的模型训练中验证可行性。从2024年到2025年,行业迅速跨越到千亿参数与万卡集群的大规模普及期。
2024年9月,中国电信在全国产万卡集群上成功运行万亿参数模型,连续有效训练时长占比突破98%,并开源了千亿级别的TeleChat2-115B模型。2025年上半年,华为发布的盘古Ultra系列1350亿参数稠密模型实现了完全自主研发计算平台的全程支撑,随后的7180亿参数混合专家架构模型更是将国产万卡集群的模型算力利用率从30%大幅拉升至41%。
进入2026年之后,万亿规模的全流程训练已经全面跑通并成为头部机构的日常操作。2026年4月,DeepSeek正式发布V4模型,并在官方技术白皮书中首次写明部分核心训练工作在华为昇腾计算平台上完成。随后在5月,百度基于昆仑芯P800构建的万卡集群成功训练了文心5.1的重要迭代版本,系统有效训练率高达97%。6月,深圳的一处技术联合攻坚团队利用1000张昇腾910C加速卡,平稳完成了参数量达1.6万亿的DeepSeek-V4-Pro全参数后训练任务。7月,美团对外开源其研发的LongCat-2.0大模型,参数量达到1.6万亿,峰值调度了超过5万张国产加速芯片,从最基础的零预训练到后期的线上推理全流程均依托本土硬件完成,创造了当时全球范围内完全依靠非NVIDIA硬件从零预训练前沿规模模型的公开范例。
这一系列扎实的工业落地实践,为智谱与DeepSeek直接使用国产集群挑战5万亿到10万亿参数模型奠定了坚实的工程基础。
根据中国半导体行业媒体与海外供应链分析机构的数据,DeepSeek除了在前期积极吸纳市场存量计算卡之外,也向华为等本土供应商开出了高达百亿元级别的计算硬件采购订单,并计划将下一代更大规模的基座预训练直接部署在昇腾集群之上。智谱在近期两轮百亿规模股权配售后,同样锁定了庞大的算力采购与租赁协议,其2026年算力订单总规模达到200亿元,2027年规划算力投入达300亿元至400亿元。在万亿级混合专家架构已经得到充分验证的前提下,将多个万卡集群通过分布式并行技术联合起来冲击5万亿乃至10万亿参数级别,已经成为技术团队有计划推进的核心任务。
基础设施重构带来的全链条推动
全球半导体供应链的不确定性加剧,在客观上成为打破技术路径依赖的强力催化剂。在过去的全球化产业分工中,由于海外成熟硬件生态极其便捷,上层算法研发往往不愿承担迁移适配的高昂试错成本,导致本土半导体企业长期难以获得顶尖算法团队的真实业务反馈。如今外部环境的变化强力促成了芯片研发与模型算法之间的紧密协同。
这种新型协同关系首先体现在软件算法对硬件物理特性的深度反哺。目前本土先进制程芯片在单卡峰值算力和内存带宽上仍然与国际最新架构存在一定客观差距,如果单纯依靠堆叠硬件数量,往往会带来机房供电负荷剧增与集群内部通信延迟放大的新问题。为了应对这些物理层面的制约,算法工程师在模型架构设计上进行了大量创新,通过广泛采用稀疏混合专家网络结构、多层级稀疏注意力机制以及8位甚至4位低精度训练方案,大幅降低了模型训练每个步骤所需的浮点运算总量。算法上节省下来的每一份计算负载,都在有效弥补硬件底层制造工艺的性能缺口。
与此同时,中国的基础设施建设力量正在为大模型技术的规模化落地开辟全新的商业空间。2026年11月6日,中国移动云与智谱在行业峰会上正式签署战略合作协议,宣布共同建设词元联合发展中心,重点推进自研芯片适配、代码生成工具研发以及重点行业应用定制。
更具行业启示意义的是,双方在战略规划中明确提出了探索通话服务、流量服务与人工智能词元服务深度绑定的全新资费模式。在这一机制下,智能计算的输出结果将演变为与通信语音和移动网络数据完全相同的日常消费计量单位,直接面向海量大众用户进行分发与结算。
中国人工智能产业正在经历一场从被动应对供应限制到主动构建全栈自主体系的转变。本土芯片与模型算法已经走出最初的演示验证阶段,深度融入实际产业生产环境。伴随着编译器中间层的统一、软硬件协同优化经验的积累以及电信基础设施的全力托底,一套具备独立运转和自我迭代能力的自主计算体系正在确立。面临外部市场多重波动的全球芯片竞争格局,也因为这种持续且坚决的技术突围被赋予了全新的发展走向。


