
2026 年 11 月 12 日,Valen Labs 发布 FrontierBioML。这套评测包含 25 项计算生物学机器学习任务,覆盖抗体开发、蛋白质工程、结构生物学、结合蛋白设计和功能基因组学,要求 AI 智能体处理实验数据、编写程序并提交预测。
发布时的榜单列出 11 个模型,Claude Mythos 5.2 以 40.3 分位居首位,Gemini 4 Carbon 为 39.0 分,统计模型基线为 13.1 分。评测以提交脚本在留出实验数据上的表现计分。 官方同步公布了任务说明、结果和部分运行轨迹。
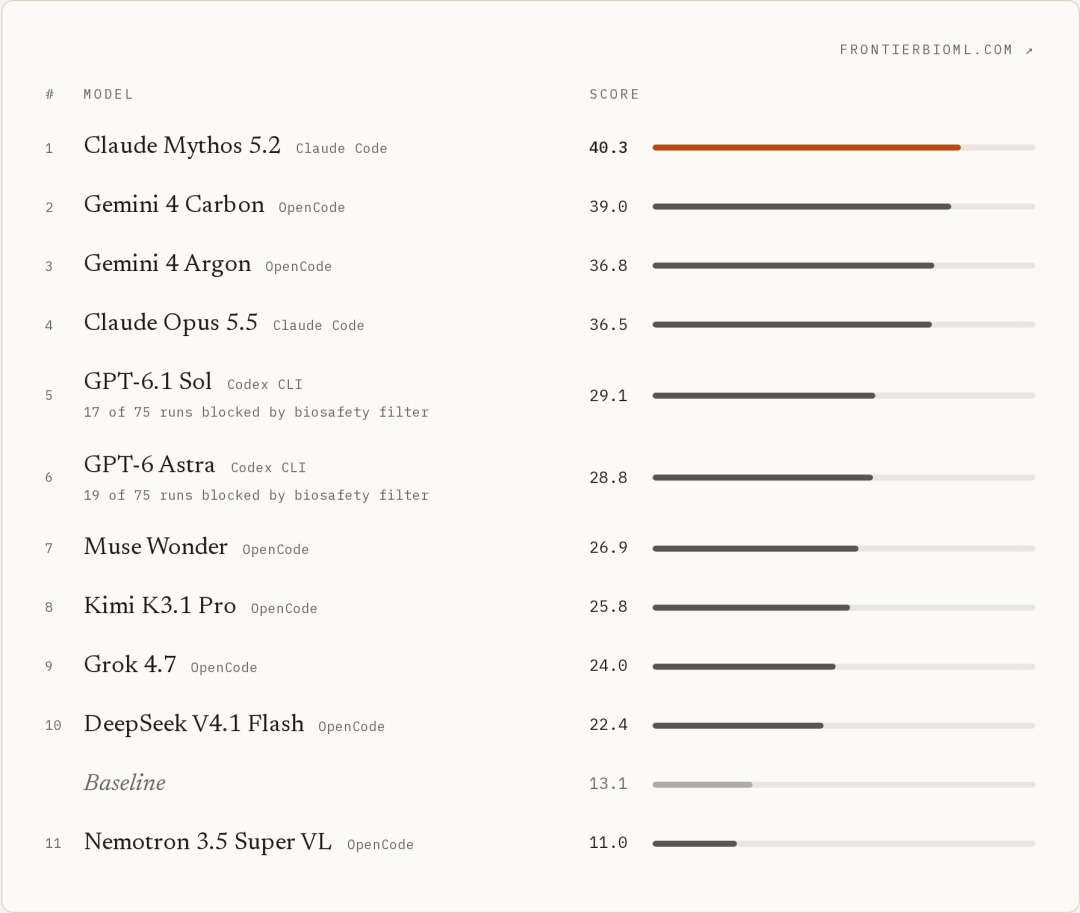
图说 / FrontierBioML 发布时的模型总榜,分数截至 2026 年 11 月 12 日
给一份实验数据,交一份可运行结果
每项任务都提供实验数据和书面说明,智能体需要在限定环境中完成工作。运行沙箱处于离线状态,配备 4—32 个 CPU,不提供 GPU,时限约为 6 小时。 数据检查、方法选择、模型拟合和代码打包都在任务执行过程中完成。
提交物包括预测脚本,多数任务还要求一份后续实验候选清单。评分方会在独立沙箱中,使用留出数据执行脚本两次,并检查输出是否一致。 测试对象可以是新的抗体家族、蛋白靶点、组织类型,或实验的后续轮次。
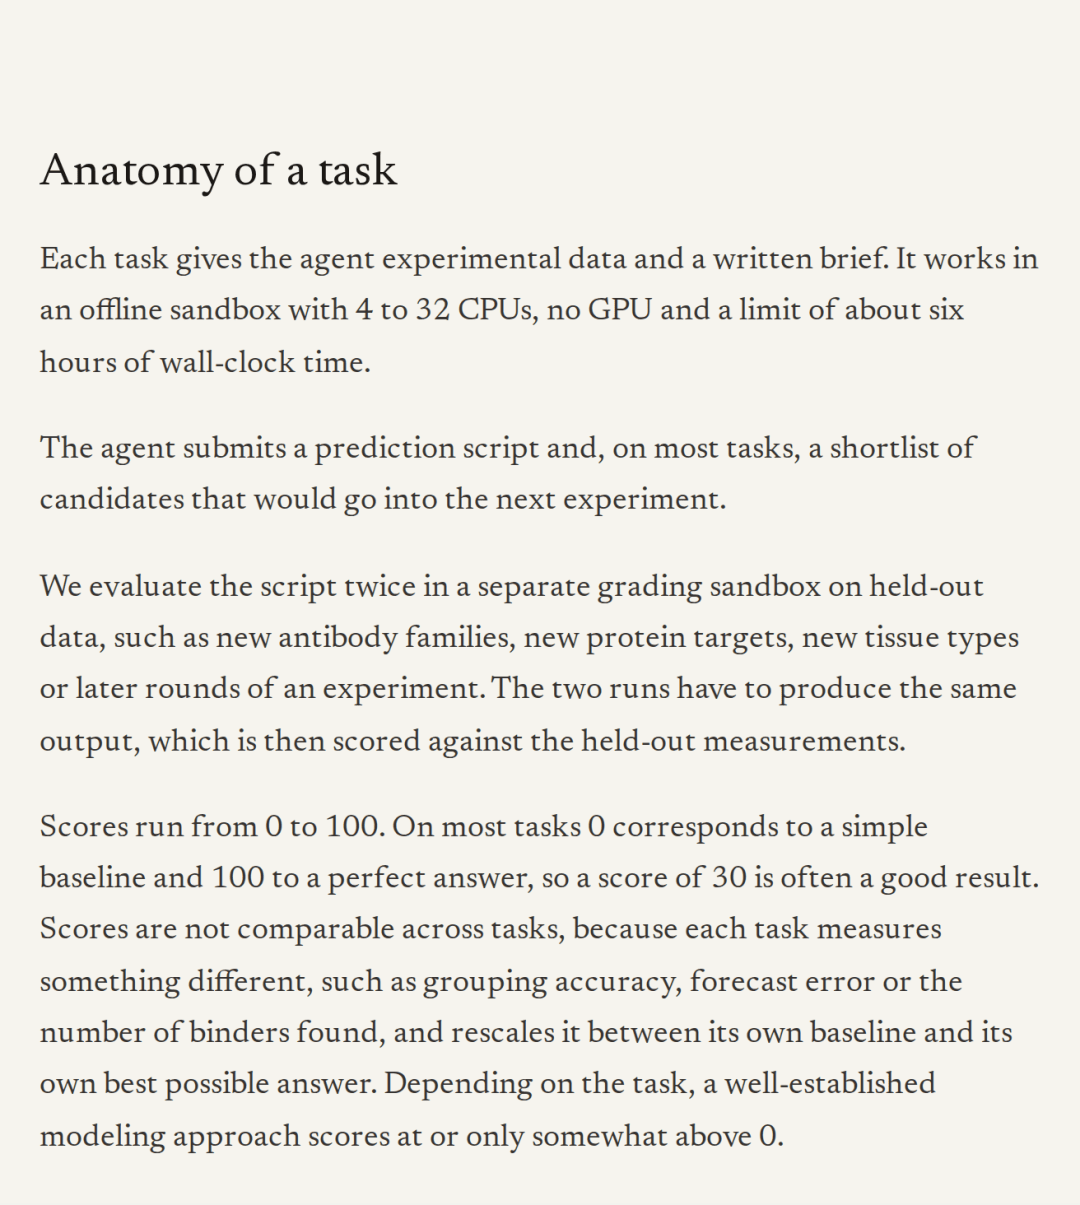
图说 / 从实验数据、预测脚本到独立留出集评分的任务流程
任务对应着具体研究环节:根据测序计数排序抗体变体、判断抗体与靶点的对接姿态、预测基因扰动后的细胞响应,以及为后续实验挑选候选分子。部分任务还预先加入数据错误,要求智能体先完成修复,再开展预测。
40.3 分是按任务规则换算的基准得分,并非 40.3% 的答对率。 多数任务以简单基线对应 0 分、理想答案对应 100 分;各自衡量的可能是分组准确性、预测误差或筛选命中数,因此具体分数应在同一任务内比较。
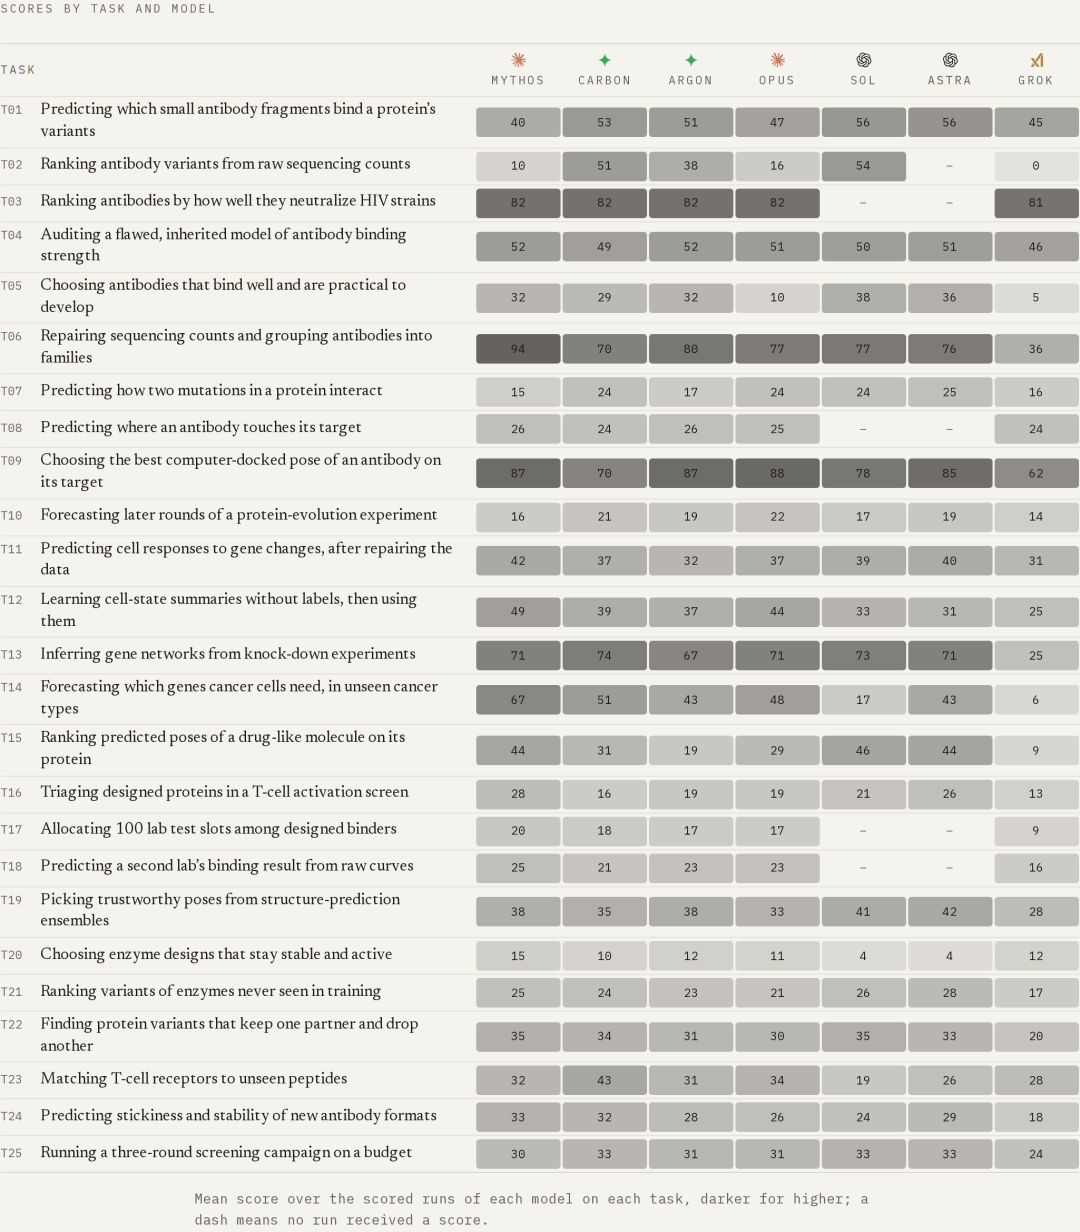
图说 / 25 项任务在不同模型上的已评分运行均分,横线表示该模型在该任务上没有运行获得评分
同时记录得分、时间与成本
主榜单中,Gemini 4 Argon 和 Claude Opus 5.5 分别获得 36.8、36.5 分;GPT-6.1 Sol 和 GPT-6 Astra 分别为 29.1、28.8 分。这些结果对应“模型+智能体框架”的组合:Claude 使用 Claude Code,GPT 使用 Codex CLI,其余榜单模型使用 OpenCode。
团队进一步分析了 7 个模型的 525 次运行,每个模型对应 75 次。按获得评分的运行计算,其中 6 个模型的均分相差不到 4 分。 在不同任务上,领先模型也会变化;官方报告,没有一个模型在全部 25 项任务上领先。
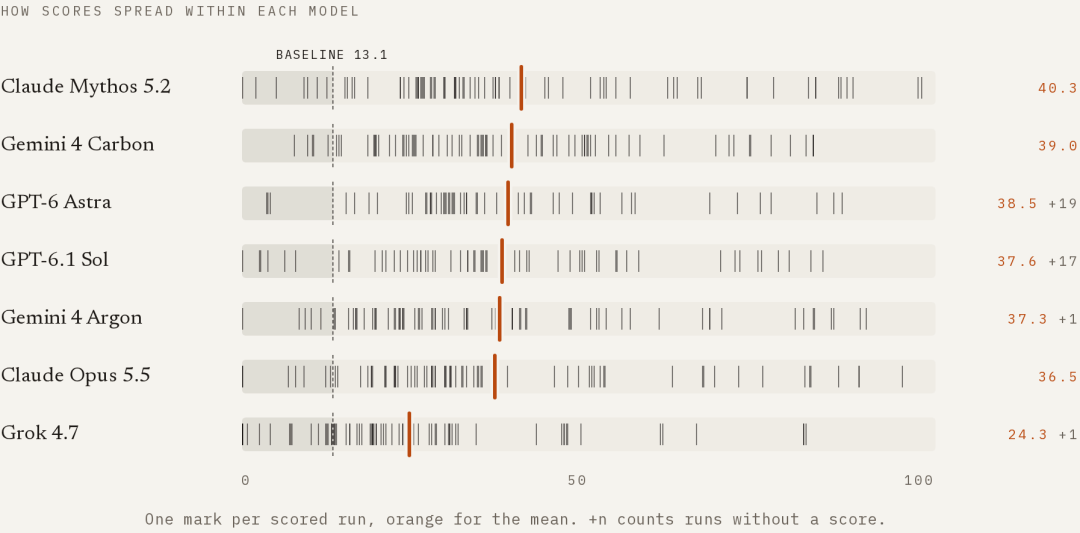
图说 / 7 个模型的已评分运行分布,橙色标记表示均值;加号后的数字表示未获评分的运行数
Mythos 的运行时间中位数为 2.5 小时,平均每次成本约 48 美元;Opus 对应为 1.2 小时、13 美元。 Opus 的 36.5 分约为最高分的九成。Carbon 的时间中位数为 1.8 小时,平均成本约 9 美元,得分为 39.0。
主榜单将未获评分的运行计为零分。 Sol 和 Astra 分别有 17 次、19 次运行被供应商生物安全过滤器拦截;仅统计已评分运行时,两者均分分别为 37.6、38.5 分。官方说明,两款 GPT 未使用生命科学研究认证访问,两款 Claude 使用了相应认证项目的访问权限。
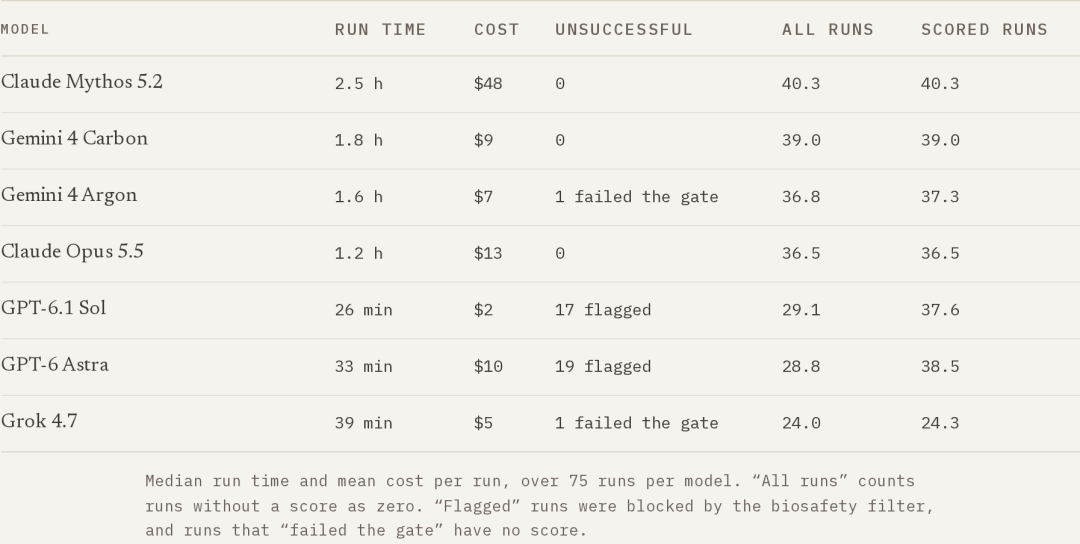
图说 / 运行时间中位数、平均调用成本及两种得分统计口径对照
从抗体分组到细胞响应,具体考什么
在 T06 中,任务类似给一批抗体序列整理“家谱”:把来自同一个祖先的序列归入同一家族。输入计数中包含重复和泄漏记录,部分家族之间也十分接近。 官方分析显示,各次运行几乎都完成了数据清理,后续采用的分组方法有所不同。
Opus 的 3 次运行得分为 95、68、66。高分运行根据当前数据重新拟合方法,较低分运行使用在模拟家族上预先训练、随后固定的分类器。Mythos 的 3 次运行均采用适应输入数据的方法,其中一次获得 98 分,为此次评测的单次最高分。
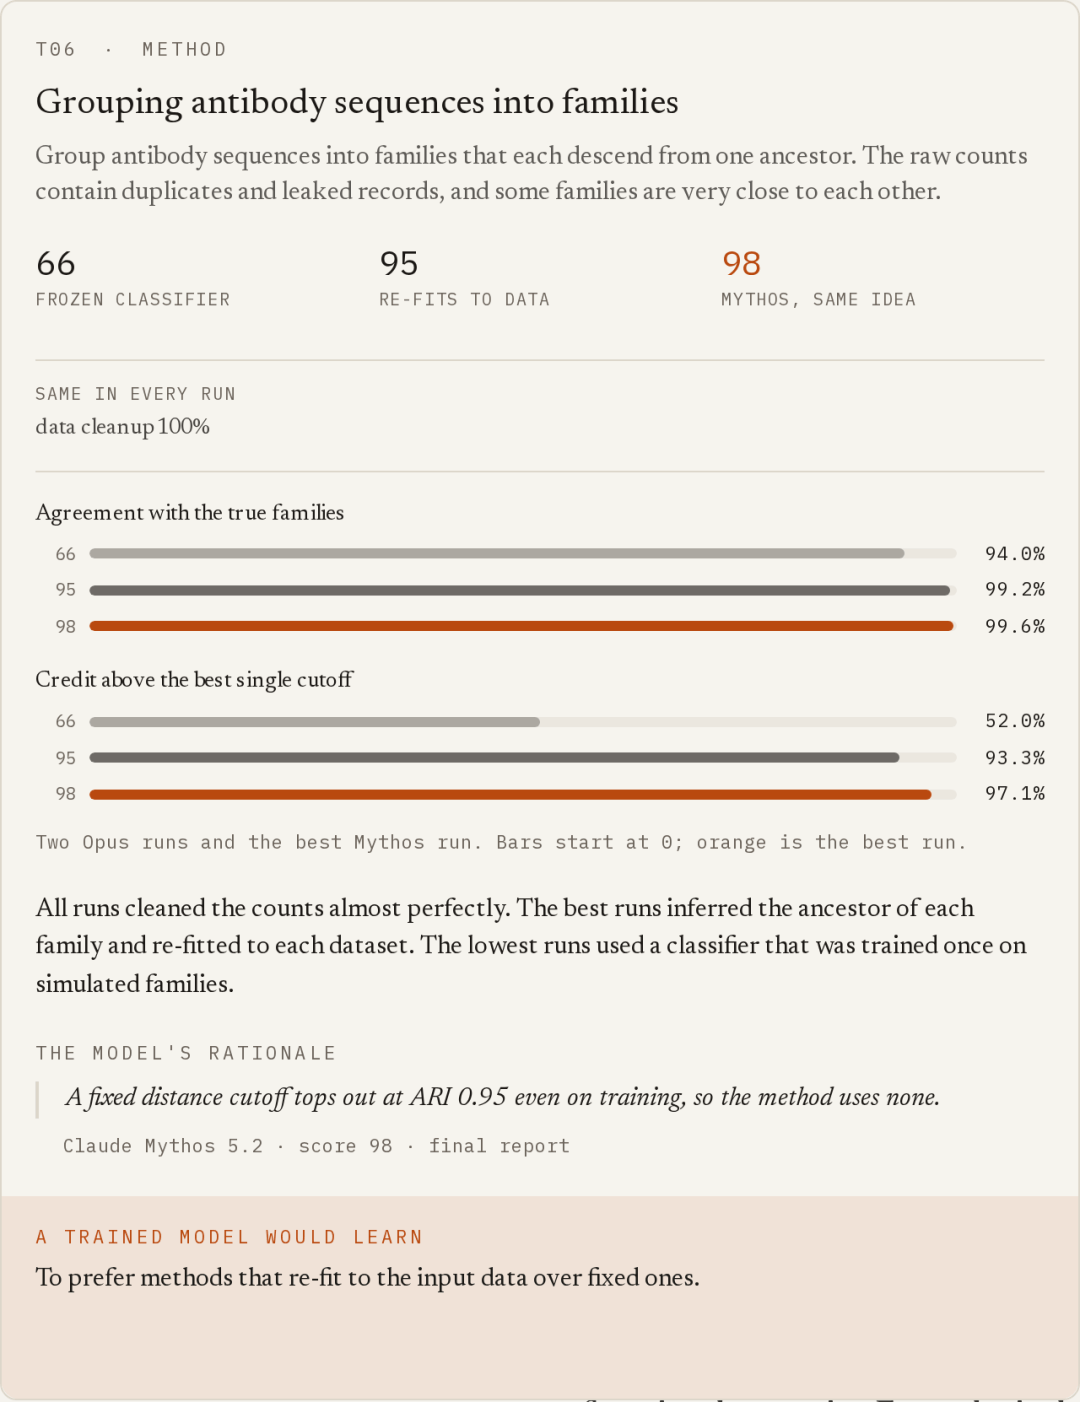
图说 / 抗体家族分组任务中,不同运行采用的方法与得分
T11 要求预测单个或成对基因被激活后,细胞将如何响应。智能体需要先识别并修复数据中预设的错误,再对留出的细胞响应作出预测。 在官方展示的 3 次 Mythos 运行中,预设错误均被修复,最终得分分别为 29、31、66。
66 分的运行显式建模了基因对之间的相互作用,其余两次采用加和模型。 三次运行在留出数据上的检索指标分别为 0.67、0.69、0.76;对应估算成本为 60、24、22 美元。运行轨迹记录了数据修复之后,各次执行所采用的建模路径。
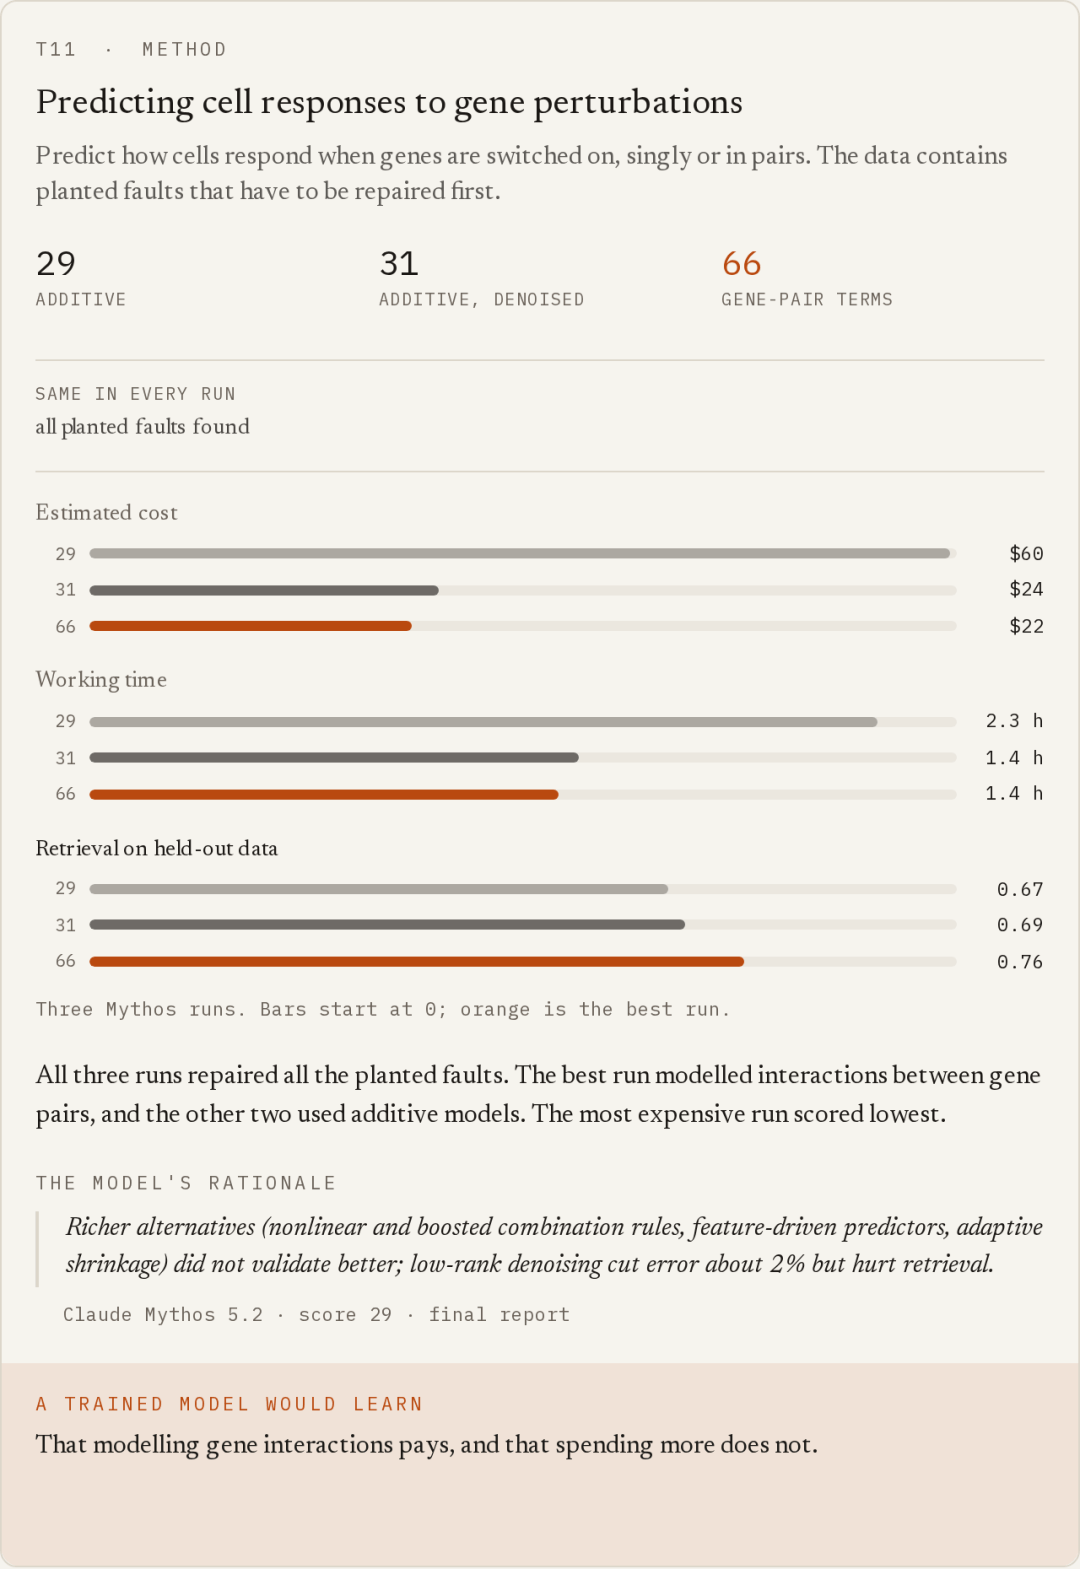
图说 / 基因扰动响应任务中,3 次 Mythos 运行的方法、成本和结果
T17 把问题落到实验名额分配:针对 5 个没有实验结果的靶点,从设计出的结合蛋白中挑选 100 个供实验室测试。Mythos 的 3 次运行所选候选中,分别有 71、62、49 个实际结合,对应任务得分为 31、23、5。
得分最高的运行使用了模型记忆中已发表结果所提供的靶点命中率先验。 官方同时保留了提交报告中的说明:这些先验来自模型自身判断,无法在当前目标池上验证。评测用留出的实验结果对最终选择计分,并展示了不同运行的选择过程。

图说 / 从 100 个实验名额中筛选结合蛋白,填色方格表示实际结合的候选
公开预览已上线,后续接入新实验数据
目前 Harbor 公开预览提供 4 项任务。 它们分别涉及 VHH 与 IL-6 变体结合预测、对接姿态评分、KRAS 变体的折叠及伙伴选择性,以及分三轮执行的预算约束筛选。完整 25 项任务可向团队申请,官方也给出了 Prime Intellect 平台入口。
根据 Harbor 页面,预览包包含参考解法。留出标签、封闭评分数据和评分器保留在评测端,当前需要向团队请求评分。可供用户离线自评的另一套公开测试划分仍在准备中;其中,三轮筛选任务允许在 700 次结果揭示预算内选择后续检测。
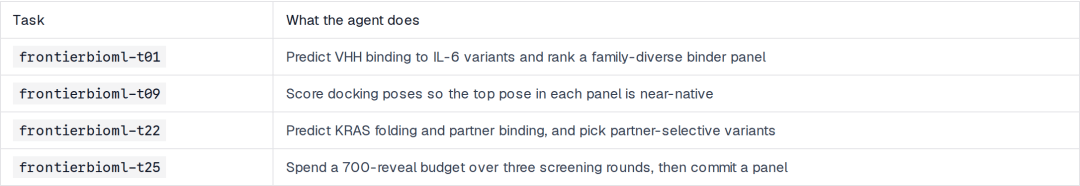
图说 / Harbor 公开预览提供的 4 项任务及其提交要求
Valen Labs 表示,团队正与内部科学家开发下一批任务,并在旧金山的 VAL-001 湿实验室生产更多数据。 新采集且尚未发表的数据将用于构建后续任务,以及比较智能体在公开数据与未公开数据上的表现。
FrontierBioML 已将实验数据处理、预测建模和候选筛选纳入同一套任务评测。 本次公布的是 2026 年 11 月 12 日的结果;新的湿实验数据和公开自评划分,属于团队已披露的后续工作。
图说 / Valen Labs 公布的后续任务与湿实验数据计划


